Betaal je voor verveelde GPU’s? Hoe AI-starvation je budget opeet
Rook en tijd maken matig vlees niet beter Ik kook graag buiten. Vuur, rook, tijd. Wat ik daarbij heb geleerd:…
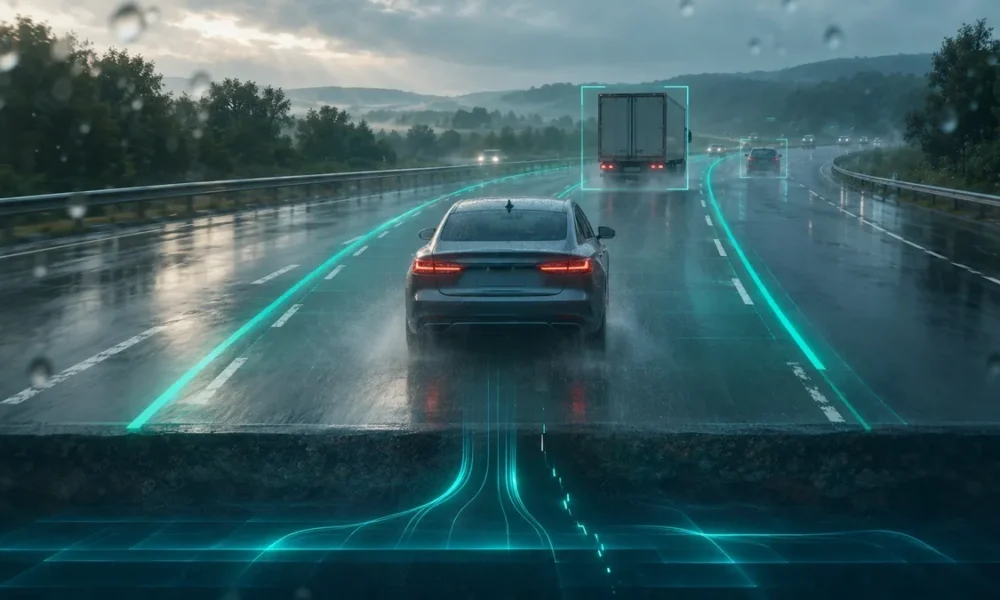
Wie in een recente auto rijdt, kent het. Lane assist houdt je tussen de lijnen en adaptieve cruise control bewaakt de afstand tot je voorganger. Tot het gaat regenen. Spray van de vrachtwagen voor je, een vieze camera achter de voorruit, wegmarkeringen die je op nat asfalt nauwelijks ziet. De auto stuurt bij terwijl dat niet nodig is, of remt voor iets wat geen obstakel blijkt te zijn. Het systeem werkt. Alleen klopt de informatie van de sensoren niet.
Edco Wallet, medeoprichter en eigenaar van OptimaData, ziet bij AI precies hetzelfde. Het model werkt, de database draait zonder foutmeldingen en toch komt er een verkeerd antwoord uit. De AI is niet stuk. De informatie eronder klopt niet.
Dit is het vijfde en laatste deel van mijn serie over de datafundering onder AI. Eerder schreef ik over AI-projecten die stranden in de testfase, over verveelde GPU’s en AI-starvation, over de vraag of je AI-koppeling NIS2-compliant is en over waarom je voor AI geen extra database nodig hebt.
Bij datacorruptie denken DBA’s aan beschadigde pagina’s, storageproblemen of checksumfouten. Daar hebben databases mechanismen voor. Lastiger is de minder zichtbare categorie. Een applicatie schrijft een verkeerde prijs weg. Een aanvaller past kortingscodes aan. Een zoekindex bevat nog informatie die in de brondatabase al is verwijderd.
Technisch zijn dat verschillende problemen: corruptie, manipulatie en verouderde data. Voor de gebruiker maakt het niets uit. Een AI-chatbot verwerkt die foute prijs in een overtuigend antwoord, aangevuld met productinformatie en een aanbeveling. De fout wordt onderdeel van een verhaal dat betrouwbaar klinkt.
Ransomware draait allang niet meer alleen om versleutelen en losgeld eisen. Aanvallers kunnen eerst accounts met ruime rechten zoeken, data stelen en herstelmogelijkheden saboteren. Soms zitten ze dagen of weken in een omgeving voordat iemand iets merkt.
Daar ontstaat een lastig probleem. Zet je een database terug naar een moment voor de zichtbare aanval, dan maak je daarmee niet automatisch alle eerdere manipulaties ongedaan. Een back-up kan technisch volledig in orde zijn, terwijl de inhoud al dagen niet meer klopt.
Veel AI-toepassingen werken met Retrieval-Augmented Generation (RAG). Het taalmodel krijgt relevante informatie aangereikt uit documenten, databases of zoekindexen en bouwt daar zijn antwoord mee. Dat is praktisch, maar het maakt je AI afhankelijk van meerdere systemen met elk hun eigen tijdlijn.
Stel je een grote webshop voor op Azure SQL Database, met een klantenservicechatbot die een zoekindex in Azure AI Search gebruikt. In die index staan producten, voorwaarden en de orderhistorie van klanten.
Via een applicatieaccount met veel te ruime rechten krijgt een aanvaller toegang tot de database. Op dinsdag verandert hij een kortingscode van 10% naar 50%. Vrijdag verwijdert hij belangrijke tabellen en wordt de aanval ontdekt.
De webshop zet de database met point-in-time restore terug naar woensdagavond, omdat de logs daar de eerste verdachte activiteit lieten zien. De gemanipuleerde kortingscode van dinsdag staat er dus nog steeds in. Ondertussen zijn alle bestellingen verdwenen die klanten op donderdag hebben geplaatst.
De zoekindex is niet teruggezet. Daarin staan die bestellingen nog wel. Een klant vraagt de chatbot naar zijn bestelling van donderdag. De chatbot vindt de bestelling in de zoekindex en bevestigt dat alles in orde is, terwijl die bestelling in de herstelde database niet meer bestaat.
Natuurlijk heeft deze webshop inmiddels een veel groter probleem dan een chatbot die verkeerde antwoorden geeft. Er zijn bestellingen verdwenen, klantgegevens zijn mogelijk gestolen en de administratie is niet meer betrouwbaar. In deze blog kijken we specifiek naar de gevolgen voor AI. Die laten zien hoe een technisch goed werkend systeem toch informatie kan geven die niet meer klopt met de werkelijkheid. De database is hersteld, de oorspronkelijke situatie niet. En de chatbot vertelt ondertussen een andere versie van de werkelijkheid.
Dit is een fictief scenario, gebaseerd op situaties die technisch mogelijk zijn bij een combinatie van een operationele database, een zoekindex en een AI-toepassing.
Zorg eerst dat de chatbot geen informatie meer verspreidt waarvan niemand weet of ze klopt. Zet hem tijdelijk uit, of sta alleen nog antwoorden toe uit bronnen die aantoonbaar betrouwbaar zijn.
Zoek daarna uit wanneer de data voor het eerst is aangepast. Combineer daarvoor auditlogs, applicatielogs en beveiligingsmeldingen. Met point-in-time restore maak je kopieën van verschillende momenten binnen de bewaartermijn, die je met elkaar vergelijkt.
Houd wel rekening met één beperking: vind je in een kopie niets verdachts, dan bewijst dat nog niet dat ze schoon is. Gebruik meerdere onafhankelijke bronnen om een zo betrouwbaar mogelijk herstelmoment vast te stellen, en controleer daarna of de herstelde data ook inhoudelijk klopt.
Kijk dan naar de rest van de keten. Bouw de zoekindex opnieuw op vanuit de herstelde data en controleer of verouderde documenten er echt uit zijn. Alleen opnieuw indexeren is niet altijd genoeg.
Pak tot slot de oorzaak aan. Geef het applicatieaccount alleen de rechten die het nodig heeft (least privilege), en sluit de toegang af waarlangs de aanvaller binnenkwam.
DBA’s kennen RPO en RTO: hoeveel dataverlies je accepteert en hoe snel een dienst terug moet zijn. Alleen leggen organisaties die vaak per systeem vast.
Stel dat je database in vijftien minuten terug is. Daarna bouw je een zoekindex met miljoenen documenten opnieuw op, en dat duurt zes uur. Je database is beschikbaar, je AI-dienst niet.
Bij AI-toepassingen kijk je dus naar de hele keten. Hoe snel herstel je de bron? Hoe lang duurt het om de index op te bouwen? En hoe controleer je of alle systemen weer hetzelfde zeggen? Die vragen beantwoord je liever voordat het misgaat.
Een goede back-upstrategie blijft de basis: passende bewaartermijnen, gescheiden toegangsrechten en waar mogelijk immutable opslag. Niet elke back-upvoorziening biedt dezelfde bescherming, dus controleer welke garanties je cloudprovider daadwerkelijk geeft tegen wijziging of verwijdering.
Ook een immutable back-up kan gemanipuleerde data bevatten. Immutable opslag beschermt een back-up tijdens de ingestelde bewaartermijn tegen wijziging of verwijdering, afhankelijk van de technologie en configuratie. Of de inhoud klopte toen de back-up werd gemaakt, zegt het niets over. Test daarom twee dingen: of een restore slaagt, en hoe je daarna vaststelt dat de data betrouwbaar is.
Dat raakt direct aan de Europese NIS2-richtlijn en de Nederlandse Cyberbeveiligingswet, die sinds 15 augustus 2026 van kracht is. Voor organisaties die onder deze wet vallen, horen onder meer incidentbeheer, back-upbeheer en bedrijfscontinuïteit bij hun beveiligingsverplichtingen. Bouw je je aanpak op NEN-EN-ISO/IEC 27001:2023+A1:2024, dan vraagt die norm ook om back-ups die je regelmatig test.
Een herstelprocedure op papier geeft weinig zekerheid als je niet weet of ze in de praktijk werkt. Hangt je AI af van meerdere databronnen en indexen, dan horen die ook in je herstelstrategie thuis.
In vijf delen keken we naar de datafundering onder AI: projecten die stranden op weg naar productie, GPU’s die op data staan te wachten, AI-koppelingen die nieuwe beveiligingsvragen oproepen, een extra silo die geen oplossing blijkt, en nu data waarop je AI vertrouwt terwijl die niet meer te vertrouwen is.
Steeds zie je hetzelfde patroon. Een goed model alleen is niet genoeg. De beschikbaarheid, prestaties, beveiliging en betrouwbaarheid van de dataketen eronder bepalen of AI in productie waarde toevoegt. Of korter: je AI is pas slim als je database dat is.
Je kunt de beste rijhulpsystemen hebben, maar met sensoren die verkeerde informatie doorgeven, rijd je niet veilig. Een systeem dat altijd antwoord geeft, is nog geen systeem waarop je kunt vertrouwen.
Benieuwd hoe betrouwbaar de datafundering onder jouw AI-toepassingen is? Vraag de AI Data Readiness QuickScan aan.
AI Data Readiness QuickScan aanvragen