Waarom AI-projecten stranden in de testfase
Het probleem zit zelden bij het model Zodra een AI-project tegenvalt, valt al snel de conclusie dat het model niet…


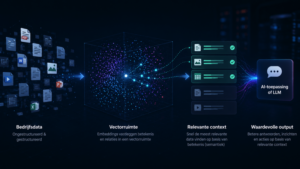
Veel RAG-toepassingen, semantische zoekfuncties en AI-agents die met jouw bedrijfsdata werken, maken gebruik van vector search. Het is een manier om embeddings op te slaan en snel relevante stukken data terug te vinden voor je taalmodel. Daarmee geef je een model toegang tot relevante context uit je eigen data.
OptimaData ondersteunt bij het ontwerpen, inrichten, optimaliseren en beheren van vector databases, of dat nu een losse oplossing is zoals Pinecone of Weaviate, of een uitbreiding van een database die je al hebt, zoals pgvector op PostgreSQL. Onze Database Platform Engineers combineren jarenlange database-expertise met kennis van embeddings, indexeringsstrategieën en retrievalpatronen.
Een vector database slaat vectorrepresentaties (embeddings) van tekst, afbeeldingen of andere data op. Een embedding is een reeks getallen die eigenschappen en betekenis van de oorspronkelijke data representeert. In plaats van alleen op exacte matches te zoeken, maakt vector search het mogelijk om te zoeken op gelijkenis: welke vectoren liggen dicht bij elkaar in de vectorruimte.
Bij grotere datasets wordt hiervoor vaak approximate nearest neighbor search (ANN) gebruikt. Daarmee kun je snel relevante context ophalen op basis van gelijkenis in plaats van alleen exacte trefwoorden. Dat maakt vector search een veelgebruikte bouwsteen voor RAG-toepassingen en semantische zoekfunctionaliteit.
Bekende indexeringsalgoritmes hiervoor zijn HNSW (Hierarchical Navigable Small World) en IVFFlat. Beide maken een afweging tussen snelheid, geheugengebruik en nauwkeurigheid (recall), en die afweging goed instellen is precies waar veel implementaties misgaan. Een verkeerd geconfigureerde index kan razendsnelle, maar onnauwkeurige resultaten opleveren, of andersom: accuraat maar te traag voor productiegebruik.
Een paar jaar geleden was vector search vooral het domein van gespecialiseerde toepassingen. Met de opkomst van generatieve AI, RAG en semantische zoekfunctionaliteit is het inmiddels een belangrijk onderdeel geworden van veel AI-projecten.
Het probleem is dat vector databases vaak worden neergezet als losse, geïsoleerde component naast de rest van het dataplatform, zonder dat er integraal naar wordt gekeken. Het gevolg kan zijn: verouderde of dubbele data in de vector store, embeddings die niet meer overeenkomen met de actuele brondata, en retrieval die trager of minder nauwkeurig wordt zodra het volume groeit.
Dit is exact de reden waarom we zeggen: je AI is pas intelligent als je database dat is. Een vector database is geen vervanging voor een goede datafundering, het is een extra laag of functionaliteit binnen je dataplatform. En die verdient dezelfde aandacht voor datakwaliteit, indexering, beveiliging en performance als elke andere kritieke database.
Er zijn inmiddels veel opties, met grote verschillen in architectuur, schaalbaarheid, kosten en de mate waarin ze zich laten integreren met wat je al hebt. Onderstaand een overzicht van veelgebruikte oplossingen. Deze lijst is niet uitputtend en wordt doorlopend aangevuld.
pgvector is een extensie die vector similarity search rechtstreeks toevoegt aan PostgreSQL. Geen aparte vector database of aparte infrastructuur: relationele data, metadata en vectoren kunnen naast elkaar in dezelfde PostgreSQL-database en zelfs in dezelfde tabellen staan.
Meest genoemde pluspunten:
Meest genoemde minpunten:
m, ef_construction en ef_search vraagt database- en performancekennis en wordt in de praktijk gemakkelijk onderschatBelangrijke nuance: als de oorspronkelijke tekst of data verandert, genereert pgvector niet automatisch een nieuwe embedding. De applicatie of datapipeline blijft verantwoordelijk voor het opnieuw genereren en opslaan van embeddings.
Pinecone is een volledig managed vector database die specifiek is gebouwd voor grootschalige similarity search. Je beheert niet zelf de onderliggende database-infrastructuur, maar werkt voornamelijk via API’s en de diensten van Pinecone.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Weaviate is een open-source vector database met ondersteuning voor onder andere vector search en hybride zoekopdrachten: een combinatie van vector search en traditionele keyword search.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Qdrant is een open-source vector database geschreven in Rust, met veel aandacht voor vector retrieval, filtering en efficiënt resourcegebruik.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Milvus is een open-source vector database ontworpen voor grote en gedistribueerde vectorworkloads.
Meest genoemde pluspunten:
Meest genoemde minpunten:
MongoDB ondersteunt vector search naast documentdata, zodat embeddings en de bijbehorende data binnen het MongoDB-platform kunnen worden gecombineerd.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Vector Search is niet meer uitsluitend beschikbaar in Atlas: recente MongoDB-versies bieden deze functionaliteit ook voor bepaalde Enterprise- en Community-deployments. Controleer daarom per versie en deploymentmodel welke mogelijkheden beschikbaar zijn.
Beide platformen hebben hun bekende zoekmachinefundament uitgebreid met vector search, boven op hun sterke tekst- en filtermogelijkheden.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Azure AI Search is Microsofts managed zoekdienst met geïntegreerde vector search en nauwe integratie met het Azure AI-ecosysteem.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Redis ondersteunt vector search binnen het Redis-platform en kan door zijn memory-first architectuur zeer lage latency bieden voor realtime toepassingen.
Meest genoemde pluspunten:
Meest genoemde minpunten:
Los van welk platform je kiest, zien we bij vrijwel elke vector database-implementatie dezelfde aandachtspunten terugkomen.
Ook bij een volledig managed vector database geldt: de provider beheert een groot deel van de infrastructuur, maar daarmee is je retrieval niet automatisch optimaal afgestemd op jouw data en use case. Indexparameters, chunking-strategie, embeddingkeuze en metadata-filtering blijven belangrijke ontwerpkeuzes, ongeacht welk platform je kiest.
Een vector database maakt slechte brondata niet beter, hij maakt de data vooral op een andere manier doorzoekbaar. Als je chunking-strategie niet klopt of je brondata verouderd of inconsistent is, kan ook een technisch snelle retrieval het verkeerde antwoord opleveren. Datakwaliteit is en blijft een fundamentele stap.
Bij approximate nearest neighbor search bestaat in de praktijk een afweging tussen recall, latency en resourcegebruik. Meer kandidaten onderzoeken kan de kans vergroten dat je de meest relevante resultaten vindt, maar vraagt ook meer rekenwerk. Deze afweging goed instellen en periodiek herzien naarmate je dataset groeit, is precies het soort tuningwerk dat vaak wordt overgeslagen bij de eerste implementatie.
Een aparte vector database toevoegen aan je landschap betekent een extra component om te beheren, te beveiligen en synchroon te houden met je brondata. Voor veel organisaties is het daarom het overwegen waard of vectorfunctionaliteit binnen een database of zoekplatform dat je al hebt niet net zo goed of beter past, zeker als je datavolumes en use case dat toelaten.
Vectoren kunnen veel opslag- en indexruimte vragen. Een vector van 1536 dimensies die als 32-bit floats wordt opgeslagen, gebruikt alleen voor de vectorwaarden al ongeveer 6 KB. Bij één miljoen vectoren is dat grofweg 6 GB aan ruwe vectorwaarden, nog zonder metadata, indexstructuren en database-overhead.
Dat vertaalt zich in infrastructuur- en cloudkosten, zeker bij memory-intensieve oplossingen. Een goede capaciteitsplanning vooraf voorkomt verrassingen op de factuur.
De embeddings zelf zijn doorgaans overdraagbaar zolang het doelplatform het datatype, de dimensionaliteit en de gebruikte distance metric ondersteunt. De grotere migratie-uitdaging zit vaak ergens anders: API’s, schema’s, metadatafilters, indexconfiguraties, namespaces of collections, ingest pipelines en retrievallogica verschillen per platform.
Eenmaal gekozen kan overstappen daardoor alsnog substantieel werk zijn. Een bewuste keuze vooraf blijft dus belangrijk.
Wij zien de vector database niet als een geïsoleerd AI-onderdeel, maar als een integraal onderdeel van je datafundering. Onze Database Platform Engineers combineren klassieke database-expertise — indexering, performance tuning en datamodellering — met kennis van embeddings en retrievalpatronen, ongeacht of je kiest voor pgvector, een gespecialiseerd platform of een hybride aanpak.
Twijfel je of je huidige dataplatform klaar is voor vector search en de AI-workloads die erop gaan draaien? Daar hebben we de AI Data Readiness QuickScan voor.